在上一篇文章中,我们讲了线搜索是如何确定步长的。能确定步长的前提是已经确定了方向,而如何确定方向则是连续优化算法设计中最重要的一环。从这一篇文章开始,我们将一起从零发明多种经典的连续优化方法,一起理解这些方法是怎么确定方向的。
接上一篇文章,ϕ(α)=f(xk+αpk)。要使 ϕ(α) 下降,pk 方向上必须存在一个点使得 ϕ(α⋆)<ϕ(0)。直觉上看,这个条件可以通过往梯度下降的方向走来解决,也就是使得 ∇f(xk)⊤pk<0。
在 f(xk) 的附近,f(xk+pk) 可以用一阶泰勒展开近似表现为 f(xk+pk)≈f(xk)+∇f(xk)⊤pk。f(xk) 和 ∇f(xk) 显然都是目前已知的常量,所以,既然我们希望能取到一个 pk 使 f(xk)+∇f(xk)⊤pk 最小,我们就应该让 ∇f(xk)⊤pk 尽可能小,也就是让 pk 的方向正好与 ∇f(xk) 相反。
这里的 f(xk+pk) 只是一个简化模型。而实际上,由于我们在 f(xk+αkpk) 中还提供了一个额外的步长变量 αk,所以 pk 并不一定要满足 ∥pk∥=1,直接取 pk=−∇f(xk) 就好。
Lipschitz 连续性约束
Lipschitz 连续条件,又叫 L-光滑,是数学上用来限制函数变化速度的一个光滑性条件。它强于“连续性”,但又弱于“可微性”。数学上,它的定义是
∣∇f(x)−∇f(y)∣≤L∣x−y∣,∀x,y∈Rn(L>0)
这个条件可以约束出一个所谓的“最优步长”。让我们一起来推理一下:
我们有微积分基本定理:
f(y)=f(x)+∫01∇f⊤(x+t(y−x))(y−x)dt
改写一下,变成
f(y)=f(x)+∇⊤f(x)(y−x)+∫01(∇f(x+t(y−x))−∇f(x))⊤(y−x)dt
由柯西不等式和 Lipschitz 条件,积分中的
≤≤(∇f(x+t(y−x))−∇f(x))⊤(y−x)∥∇f(x+t(y−x))−∇f(x)∥⋅∥y−x∥Lt∥y−x∥2
于是得到
f(y)≤f(x)+∇f⊤(x)(y−x)+2L∥y−x∥2
在我们的语境中,x=xk,y=xk+1=xk−α∇f(xk),所以带入后就得到
f(xk+1)≤f(xk)−αk(1−2αL)∥∇f(xk)∥2
要让 f(xk+1)<f(xk),就要让 αk(1−2αkL)>0。已知 αk>0,所以保证单调下降的步长区间就是 0<αk<L2。
我们也可以把 αk 看作自变量,那么单步下降量就是关于 αk 的二次函数 g(αk)=αk−2Lαk2。所以,理论上来说,αk=L1 时,单步理论下降量达到最大。也因此,标准梯度下降算法在具有 L-Lipschitz 梯度的目标函数上通常直接选取 α=L1。
Lipschitz 条件看似是一个单纯的“数学游戏”,一个莫名其妙冒出来的奇怪条件,但其实在真实场景中很常见,是现代一阶数值优化与机器学习理论中最核心、最普适的基础假设。Hessian 矩阵有界的函数、二次优化问题 f(x)=21∥Ax−b∥22、逻辑回归等都天然满足 Lipschitz 条件。
收敛速度
收敛速度有两种表示方式,一种是收敛 k 步能把误差控制到多少以内,另一种是收敛到 ϵ 精度以内需要多少步。其实这两种表示方法完全可以通过 f(k)=ϵ、k=g(ϵ) 的公式相互转换,比如说 O(k1) 就是 O(ϵ1),O(k21) 就是 O(ϵ1),等等。
由于凸函数与 Lipschitz 条件都是很常见的条件,我们就在这两个条件下进行分析。步长就取上面提到的理论最优步长 αk=L1。所以我们有
f(xk+1)≤f(xk)−2L1∥∇f(xk)∥2
又因为凸性,我们有
f(x⋆)≥f(xk)+∇f⊤(xk)(x⋆−xk)
所以
f(xk)−f(x⋆)≤∇f⊤(xk)(xk−x⋆)≤∥∇f(xk)∥⋅∥xk−x⋆∥
∥∇f(xk)∥≥∥xk−x⋆∥f(xk)−f(x⋆)
带入 Lipschitz 条件得到的公式,我们就得到
f(xk+1)≤f(xk)−2L1(∥xk−x⋆∥f(xk)−f(x⋆))2
变形得
f(xk+1)−f(x⋆)≤f(xk)−f(x⋆)−2L1(∥xk−x⋆∥f(xk)−f(x⋆))2
把误差记为 Δk=f(xk)−f(x∗),则有
Δk+1≤Δk−2L∥xk−x⋆∥21Δk2
利用 Δk+1≤Δk,
Δk+11−Δk1≥Δk+1⋅2L∥xk−x⋆∥2Δk≥2L∥xk−x⋆∥21
累加,得
Δk1≥Δ01+2Lmax∥xk−x⋆∥2k≥2Lmax∥xk−x⋆∥2k
可见 Δk=O(k1)。用另外一种表示方法,就是 O(ϵ1)。这时的收敛阶数属于次线性收敛。
当然,一些时候函数会满足一些更强的条件。比如说,在 μ-强凸且 L-光滑时,收敛速度就是 f(xk)−f∗≤O((1−Lμ)k),或者说 O(μLlogϵ1) 的,属于线性收敛。而在更弱的非凸但 L-光滑条件下,收敛速度就是 O(k1) 或者说 O(ϵ21) 的,属于次线性收敛。(这两种条件下的证明见附录)
算法瓶颈分析
高条件数下的缺陷
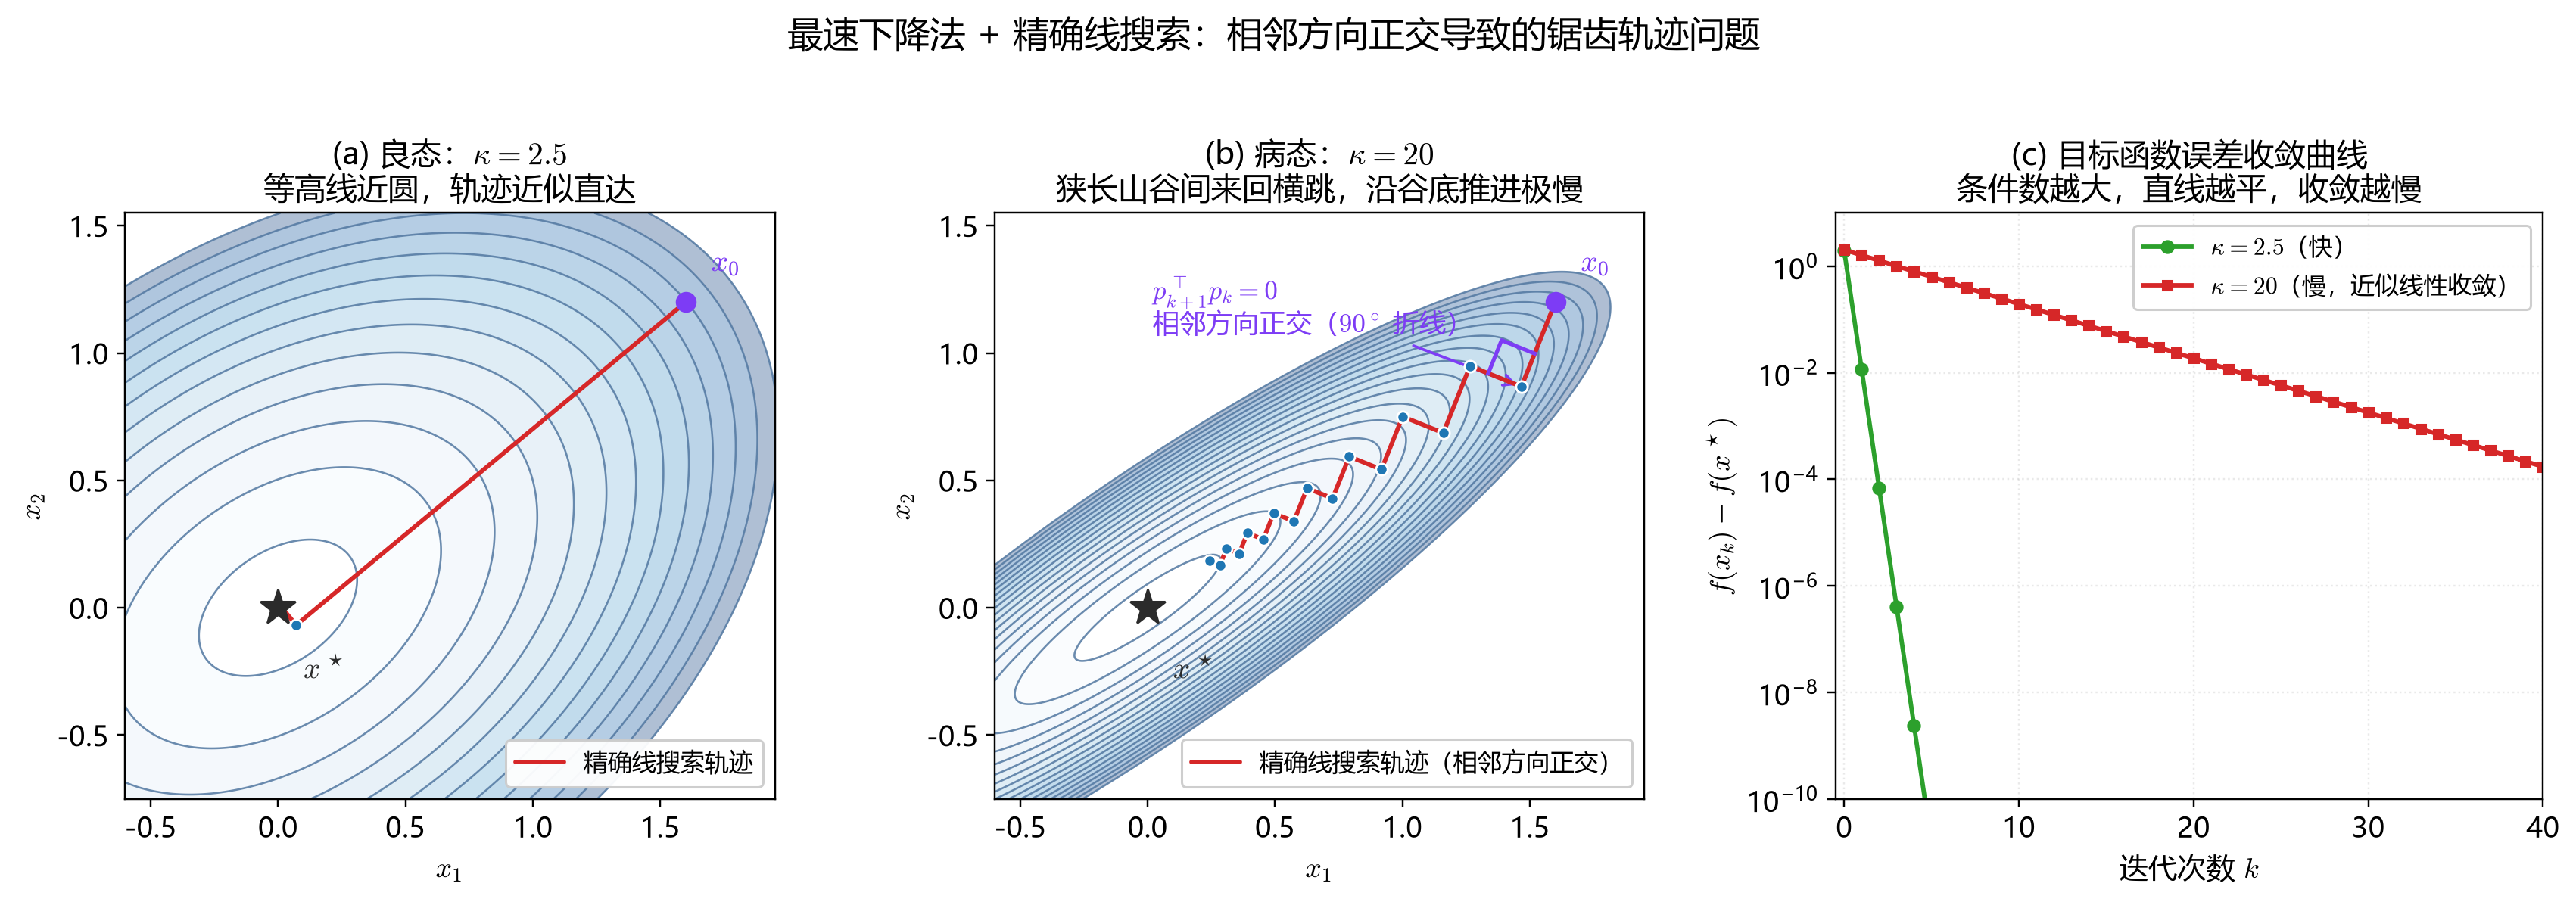
当目标函数的等高线具有极高条件数时,圆在特征空间中被拉伸为细长椭圆,负梯度方向与通往全局最小值的方向近乎正交。
精确线搜索下的特点
精确线搜索下,步长 αk 满足 ϕ′(αk)=0,即 ∇f(xk+1)⊤pk=0。
结合 pk+1=−∇f(xk+1) 和 ∇f(xk+1)⊤pk=0,可得 pk+1⊤pk=−∇f(xk+1)⊤pk=0。
由于 pk+1⊤pk=0,梯度下降轨迹在几何上很容易走出 90∘ 的直角折线。算法在狭长山谷两侧的峭壁间剧烈横跳,而沿低斜率山谷底部的推进极其缓慢,导致收敛停滞。
附录
梯度下降在两种条件下的收敛速度
设 f 可微,取固定步长 αk=L1(与正文“收敛速度”一节的取法一致)。由正文的 L-光滑性分析已经得到下降引理
f(xk+1)≤f(xk)−2L1∥∇f(xk)∥2.(A)
下面分别讨论“μ-强凸且 L-光滑”与“非凸但 L-光滑”两种情形。记 f⋆=minf(对非凸情形取 f⋆=inff),x⋆ 为任一极小值点,并记误差 Δk=f(xk)−f⋆≥0。
非凸且 L-光滑:O(k1)
把 (A) 从 i=0 累加到 i=k,左端是一个望远镜求和:
2L1i=0∑k∥∇f(xi)∥2≤i=0∑k(f(xi)−f(xi+1))=f(x0)−f(xk+1)≤f(x0)−f⋆.
因此
0≤i≤kmin∥∇f(xi)∥2≤k+11i=0∑k∥∇f(xi)∥2≤k+12L(f(x0)−f⋆),
即
0≤i≤kmin∥∇f(xi)∥≤k+12L(f(x0)−f⋆)=O(k1).
要让 mini∥∇f(xi)∥≤ϵ,只需 k+1≥ϵ22L(f(x0)−f⋆),故迭代次数为 O(ϵ21),属于次线性收敛。这也说明:在非凸情形下,梯度下降只能保证梯度范数的一个子序列趋于零,而无法保证函数值本身收敛到某个特定的 f⋆。
μ-强凸且 L-光滑:线性收敛
第一步:把函数值误差用梯度范数控制。 μ-强凸性等价于对任意 x,y 有
f(y)≥f(x)+∇f(x)⊤(y−x)+2μ∥y−x∥2.
在 x=xk、y=x⋆ 处使用,并注意 ∇f(x⋆)=0:
f(x⋆)≥f(xk)+∇f(xk)⊤(x⋆−xk)+2μ∥x⋆−xk∥2,
移项得
f(xk)−f⋆≤∇f(xk)⊤(xk−x⋆)−2μ∥xk−x⋆∥2.
令 d=xk−x⋆,右端是关于 d 的二次函数,其最大值为 2μ1∥∇f(xk)∥2(在 d=μ1∇f(xk) 处取得)。于是
f(xk)−f⋆≤2μ1∥∇f(xk)∥2,即∥∇f(xk)∥2≥2μΔk.(B)
第二步:递推收缩。 把 (B) 代入 (A):
Δk+1≤Δk−2L1∥∇f(xk)∥2≤Δk−LμΔk=(1−Lμ)Δk.
由于 μ≤L,收缩因子满足 1−Lμ∈[0,1)。递推展开得
Δk≤(1−Lμ)kΔ0,即f(xk)−f⋆=O((1−Lμ)k).
第三步:迭代复杂度。 要求 Δk≤ϵ,只需
(1−Lμ)kΔ0≤ϵ⟺k≥log(1−μ/L1)log(Δ0/ϵ).
利用 log1−t1≥t (0≤t<1),有 log(1/(1−μ/L))1≤μL,于是
k=O(μLlogϵ1).
这正是正文所说的线性收敛。其中比值 κ=μL 即条件数:条件数越大,收缩因子 1−κ1 越接近 1,迭代次数越多。
补充: μ-强凸性也蕴含梯度的强单调性,即对任意 x,y 有 (∇f(x)−∇f(y))⊤(x−y)≥μ∥x−y∥2。取 y=x⋆ 并用柯西不等式,可得 ∥∇f(x)∥≥μ∥x−x⋆∥;它与 L-光滑给出的 ∥∇f(x)∥≤L∥x−x⋆∥ 一起,把函数值误差、梯度范数与到极小值点的距离三者互相控制起来。