从零发明数值最优化 1:什么是线搜索?
连续优化问题
我们常常会遇到这样的问题:给定一个函数的公式,求它的最小值。我们在初中学二次函数的时候就知道二次函数的最小值在对称轴处取到。而到了高中,我们开始求各种各样的复杂一元函数的最小值。到了大学,我们还在求最小值,不过现在变成了多维的情况。
那么,通常我们怎么求最小值呢?按之前的经验,我们会使用一些漂亮的公式,比如说二次函数的配方,比如说不等式的取等条件,然后解决掉这些题目。然而,真实的世界中,这种情况总是不常遇到的。我们面对的函数千奇百怪,没有太多好的性质,所以也很难像做试卷那样流畅地把结果搞出来。
当然,你会想到求导。解一个导数等于零的方程,这种活儿卡西欧都能干,应该不难吧?这就是第二个问题,那就是维数。只有一个自变量的单一方程确实有很成体系的近似解法。然而,对于多维函数,它的导数(更准确说,梯度)也是一个多维向量。如果让它的每一维等于零,我们就会得到多个等于零的方程,每个方程中大概率还不止一个未知数。你绝对不会想看到这个有一堆东西耦合着的超大方程组的!
线搜索
人类处理高维信息的能力并不强,所以我们总是喜欢把东西压缩成低维后再处理。这就是线搜索的来历——它的存在源于高维非线性优化最经典的一种求解范式——“先选方向,再定步长”。换而言之,就是将处于 高维空间的复杂曲面优化问题限制在过当前点 且沿向量 的一条一维射线上。这样,我们只用研究一步要走多长了。
在每次迭代中,算法先选定一个搜索方向 ,然后沿该方向寻找合适的步长 ,以更新当前解:
确定步长的过程本质上就是将高维空间中的多变量目标函数优化问题转化为一维参数 的单变量优化问题,即
确定步长的策略
精确线搜索
最容易想到的方法当然是求解
这样做理论上能获得该方向上的最大降幅;然而,求解一维极值通常涉及多次函数值和导数计算,计算成本昂贵,且参数无界时难以求解,因此很难应用。
非精确线搜索
另外一种想法是通过多次迭代,每次迭代都持续下降,最终达到一个“令人满意的位置”。这种方法不追求 达到绝对极小值,仅要求步长满足特定收敛准则,于是也大幅减少了计算量。实际上我们大多使用这种方法。
常用的确定步长准则
Armijo 条件
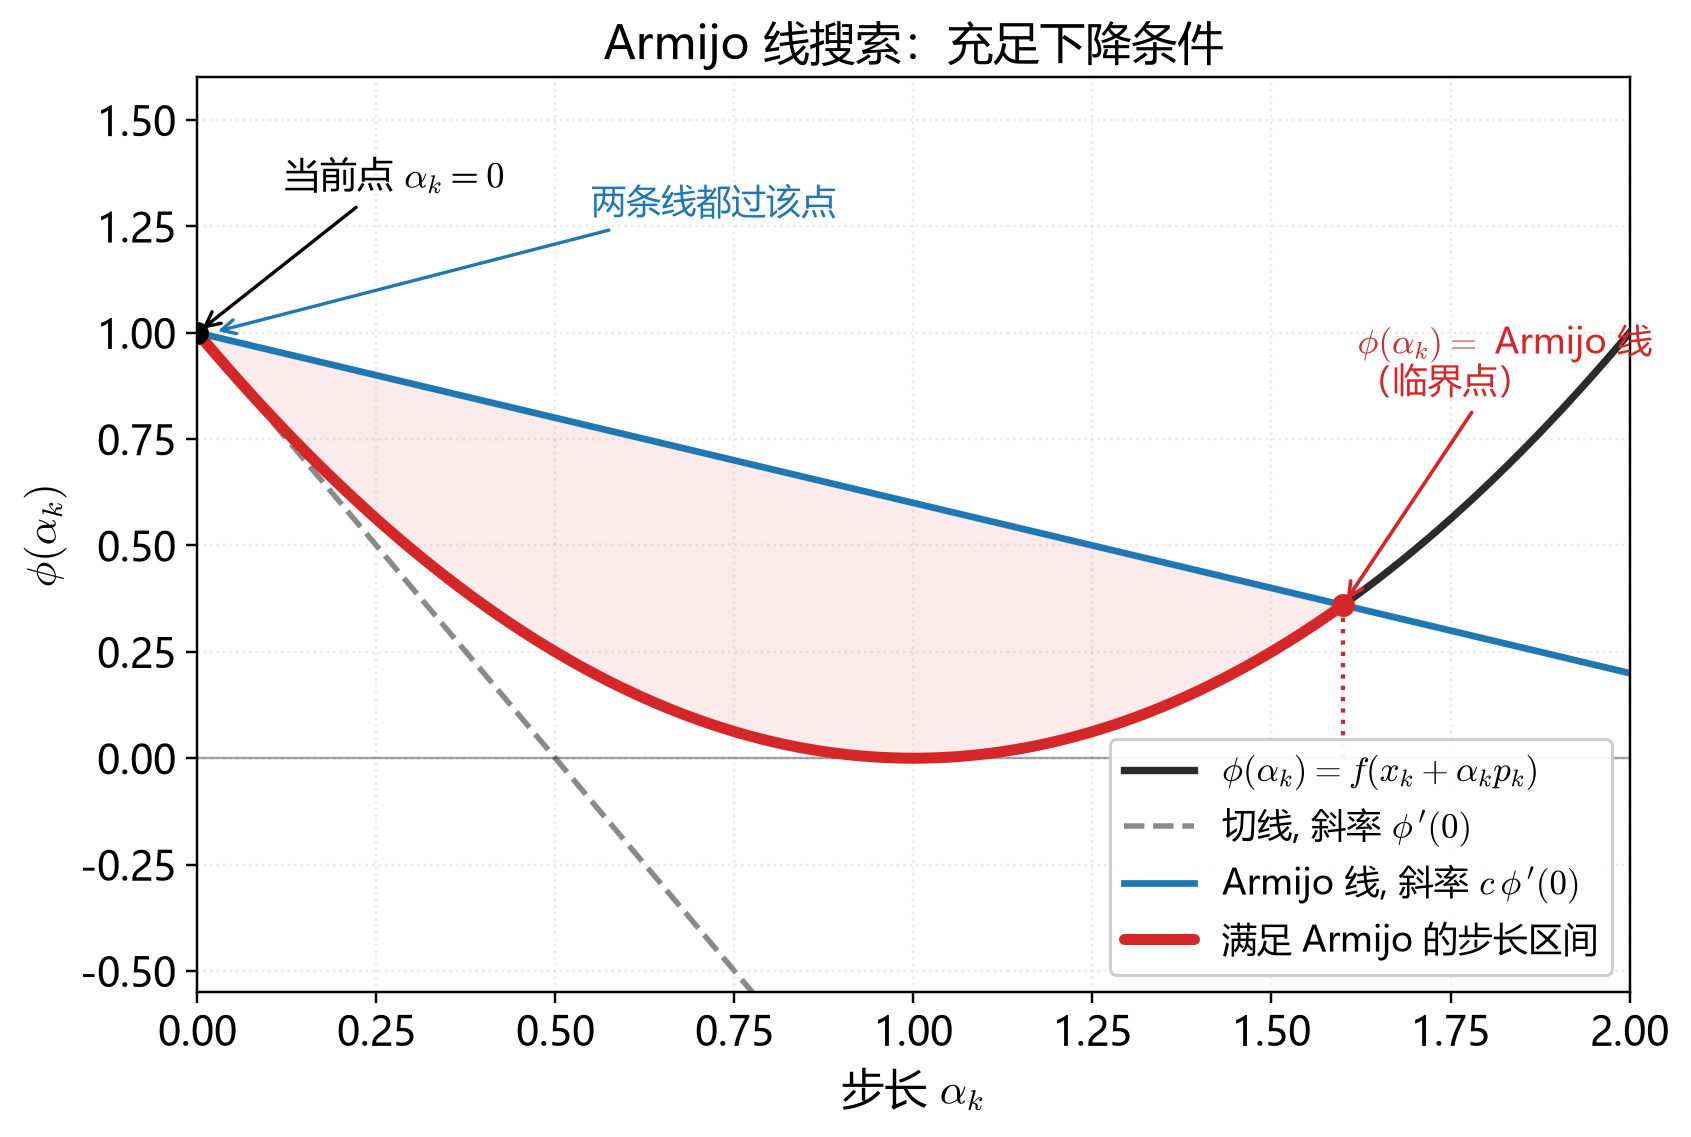
为了防止步长过大导致泰勒展开效果变差,同时考虑 的计算开销成本,通常采用 Armijo 条件调整步长。
要求
当不满足上述条件时,用回溯线搜索,从 开始,按 不断等比缩短 ,直至满足 Armijo 条件。
可以记成
其中 。
这样看,Armijo 条件本质上就是取根据出发点和方向向量唯一确定的平面,在上面画出一条以 为自变量、 为因变量的函数曲线,然后设定一个对斜率的宽限 ,使得在连续可导的情况下总能截取到一个下降步长。
Wolfe 条件
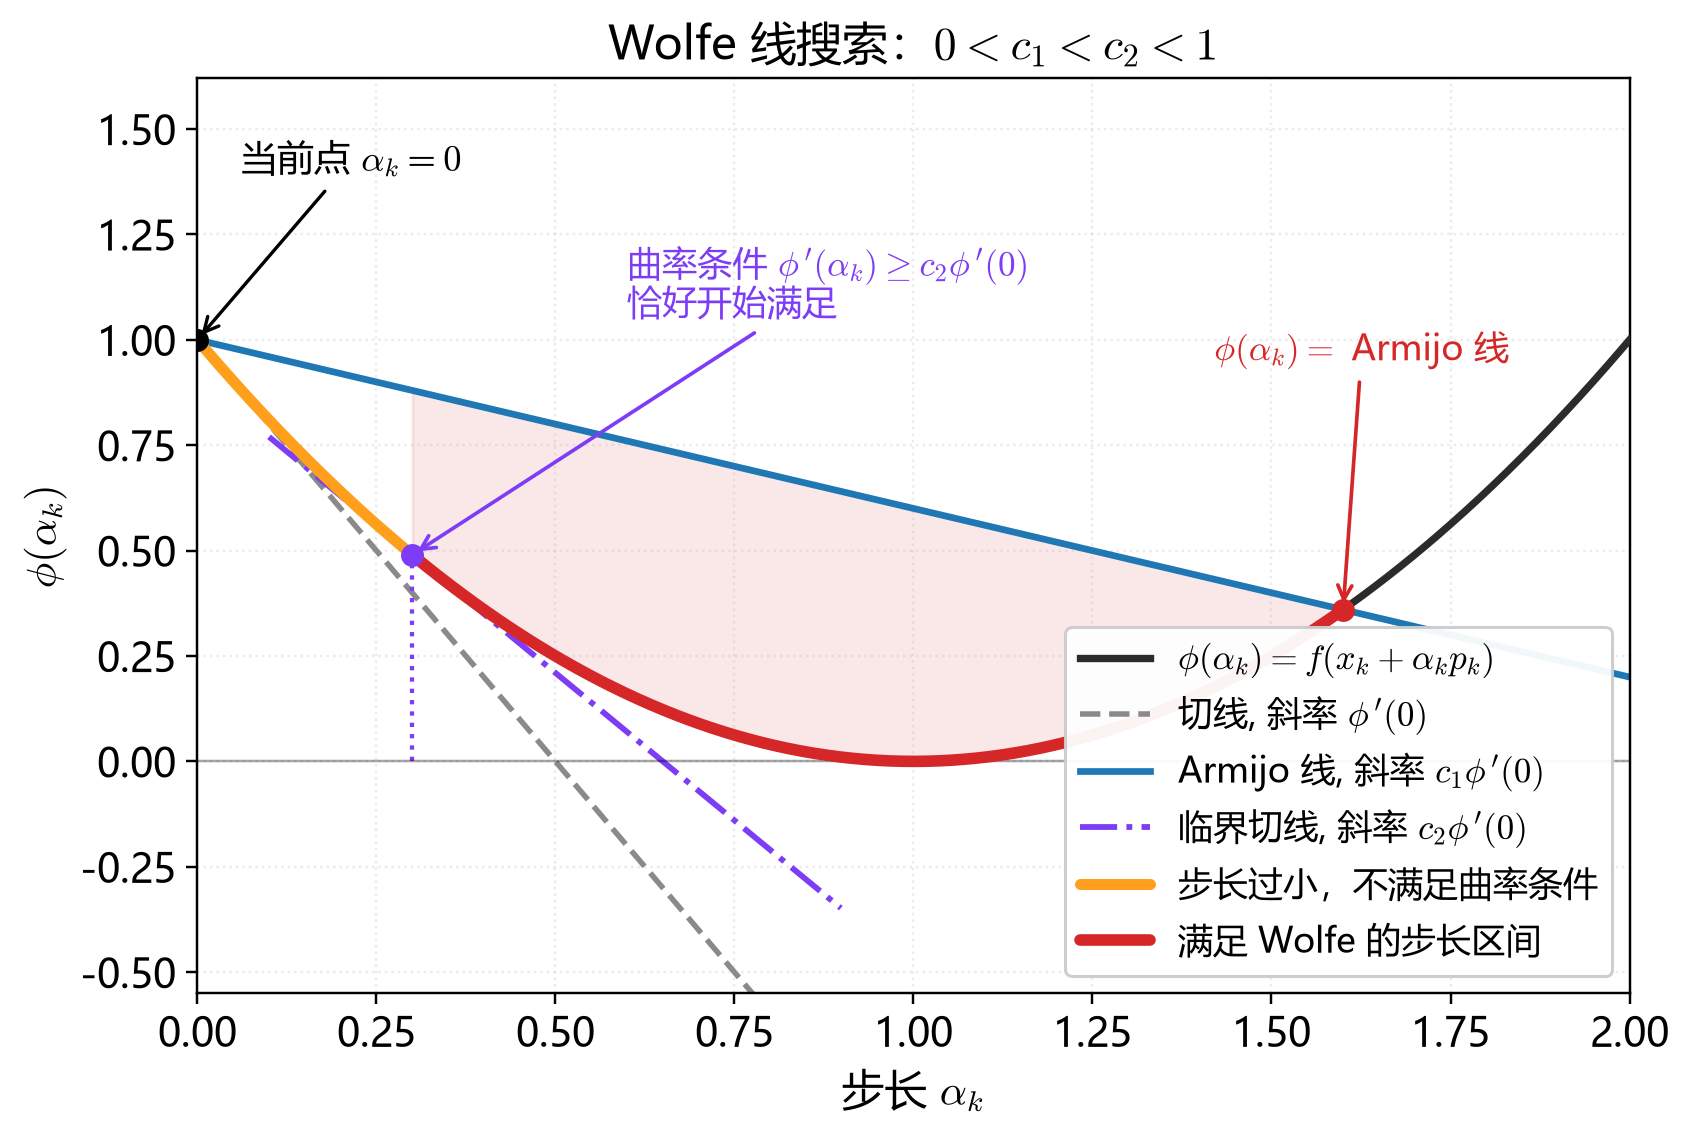
用类似的理解方式,Wolfe 法可以理解为一个不等式组:
其中 。
Wolfe 线搜索的优势在于它不会让步长一下子缩减太多,而是通过保证斜率至少大于 来规定一个步长下限。