从零发明数值最优化 7:次梯度下降法

我们之前学习的 6 篇数值最优化方法都是目标函数处处可微的光滑函数。然而,在现实问题中,我们同样经常遇到梯度不存在的问题。比如说,在机器学习中,我们就可能会使用 LASSO 回归来得到稀疏解:

min⁡x1n∥Ax−b∥22+μ∥x∥1\min_x \frac{1}{n} \Vert Ax - b \Vert _2^2 + \mu \Vert x \Vert _1

而在它折起来的那个“折点”,这些目标函数根本不可微。既然连 ∇f(x)\nabla f(x) 都找不到,那之前学的所有方法就都用不了了。

次微分

数学老师说,我们要把未知问题转化为已知问题来解决。考虑到正常来说我们要优化的函数绝无可能存在一堆不可微的点,就一般而言取到“折点”的测度为零,我们不妨“假装”函数处处可微,然后用传统方法继续做。

然而在折点的位置确实不可微,而且事实上优化算法的轨迹还偏偏容易被折点吸引,所以我们最好给它分配一个梯度。还是沿袭之前一贯的场景,对一个凸函数进行研究。不妨考虑这样的函数:

y={x2,x≤14x−3,x>1y = \begin{cases} x^2,& x \le 1 \\ 4x - 3,& x > 1 \end{cases}

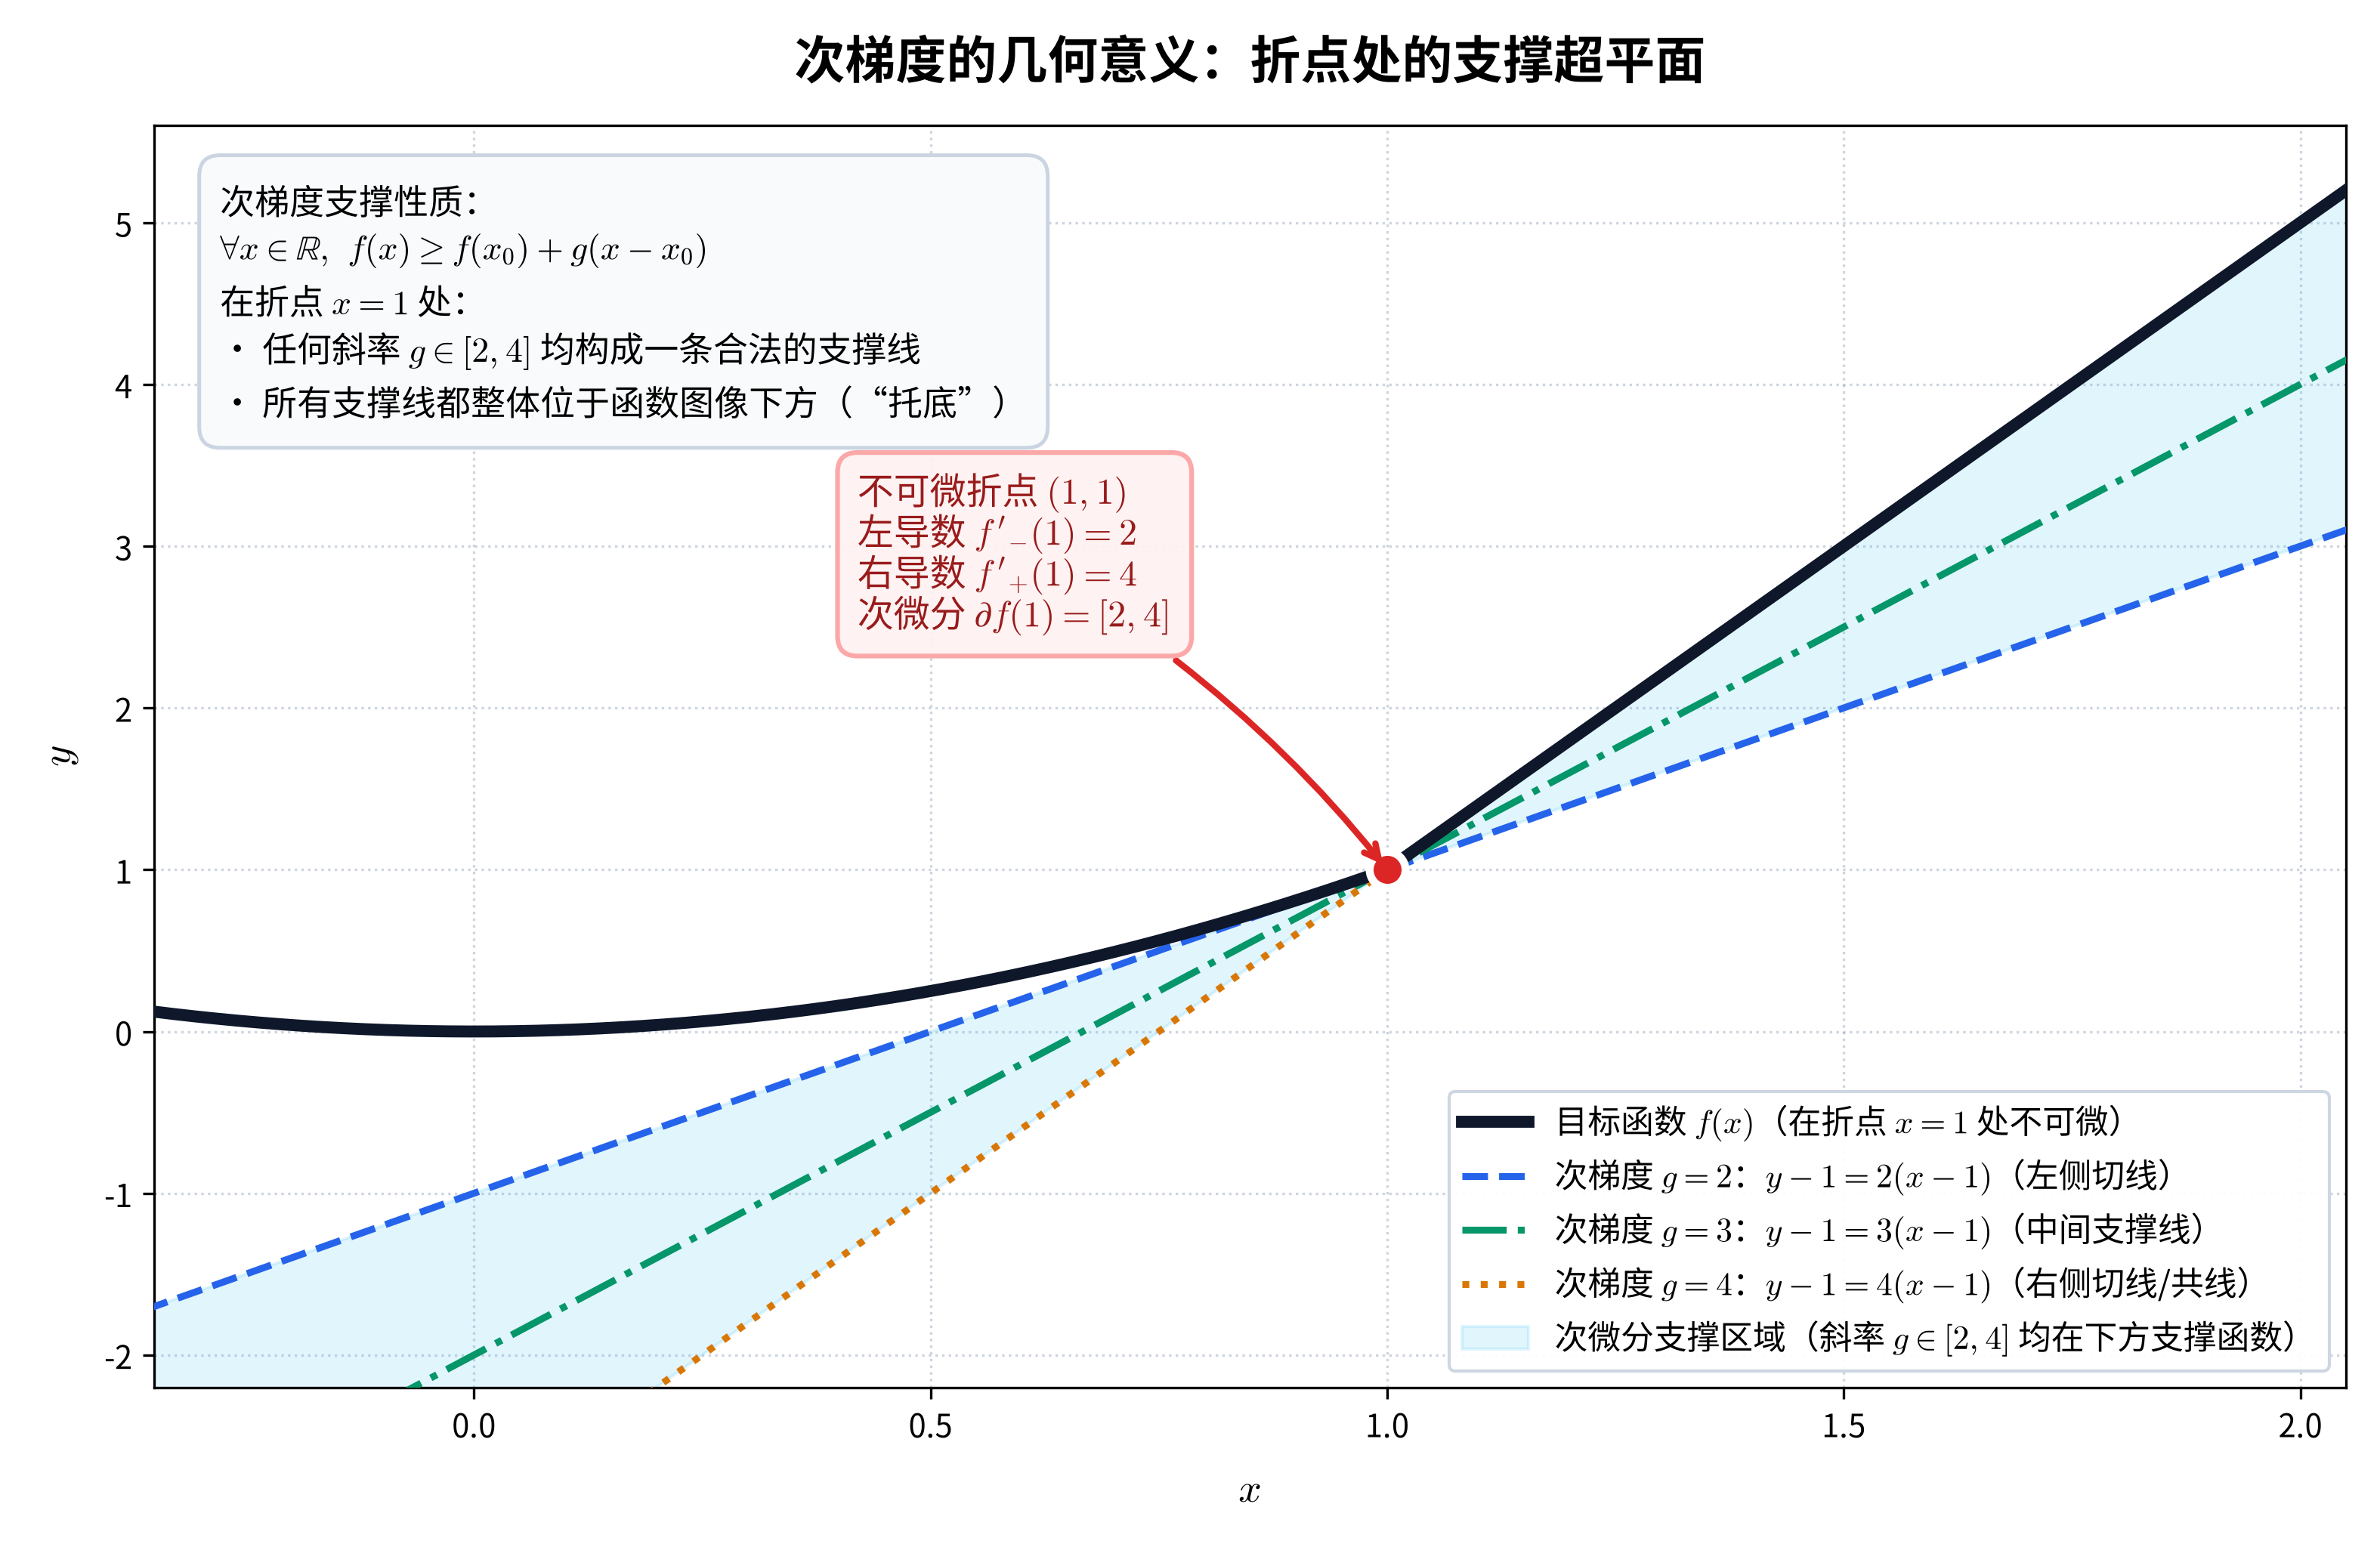
次梯度的几何意义:折点处的支撑超平面

这个函数在 x=1x=1 的地方存在一个“折点”:左边的导数是 22,右边的导数是 44。如果我们在 x=1x=1 处想找到它的下降方向该怎么办呢?

假设这个地方有梯度,那我们就应该沿着它的反方向走。直观上,这个地方的梯度应该在 [2,4][2, 4] 之间——对它的一阶泰勒展开式总归得“托住”整个函数图像嘛!而且,我们发现,这个地方梯度具体是多少好像还真不太要紧。不管是 22 还是 33 还是 44,往它们的反方向走总是下降的。也就是说,不管是拿 y−1=2(x−1)y-1=2(x-1)、y−1=3(x−1)y-1=3(x-1) 还是 y−1=4(x−1)y-1=4(x-1) 作为对这个点的线性近似,看上去都是可以接受的。

于是,我们把 g∈[2,4]g \in [2, 4] 叫作这个“折点”的“次梯度”。把这个性质扩展到高维空间,当 gg 满足

f(x+p)≥f(x)+g⊤p,∀p∈Rnf(x + p) \ge f(x) + g^\top p, \quad \forall p \in \mathbb{R}^n

时,我们就称 gg 是 ff 在 xx 处的一个次梯度。所有次梯度的集合称为次微分,记作 ∂f(x)\partial f(x)。

定义了次微分后我们还得到一个很好的性质,那就是如果 0∈∂f(xk)0 \in \partial f(x_k),那么 xkx_k 就是函数的最小值点。这正是光滑条件 ∇f(x∗)=0\nabla f(x^*) = 0 的完美扩充。

单步下降假象

原来次梯度下降跟普通梯度下降没两样嘛,随便抓一个次梯度走就完事了!你刚刚是这么以为的吗?然而事实并非如此。

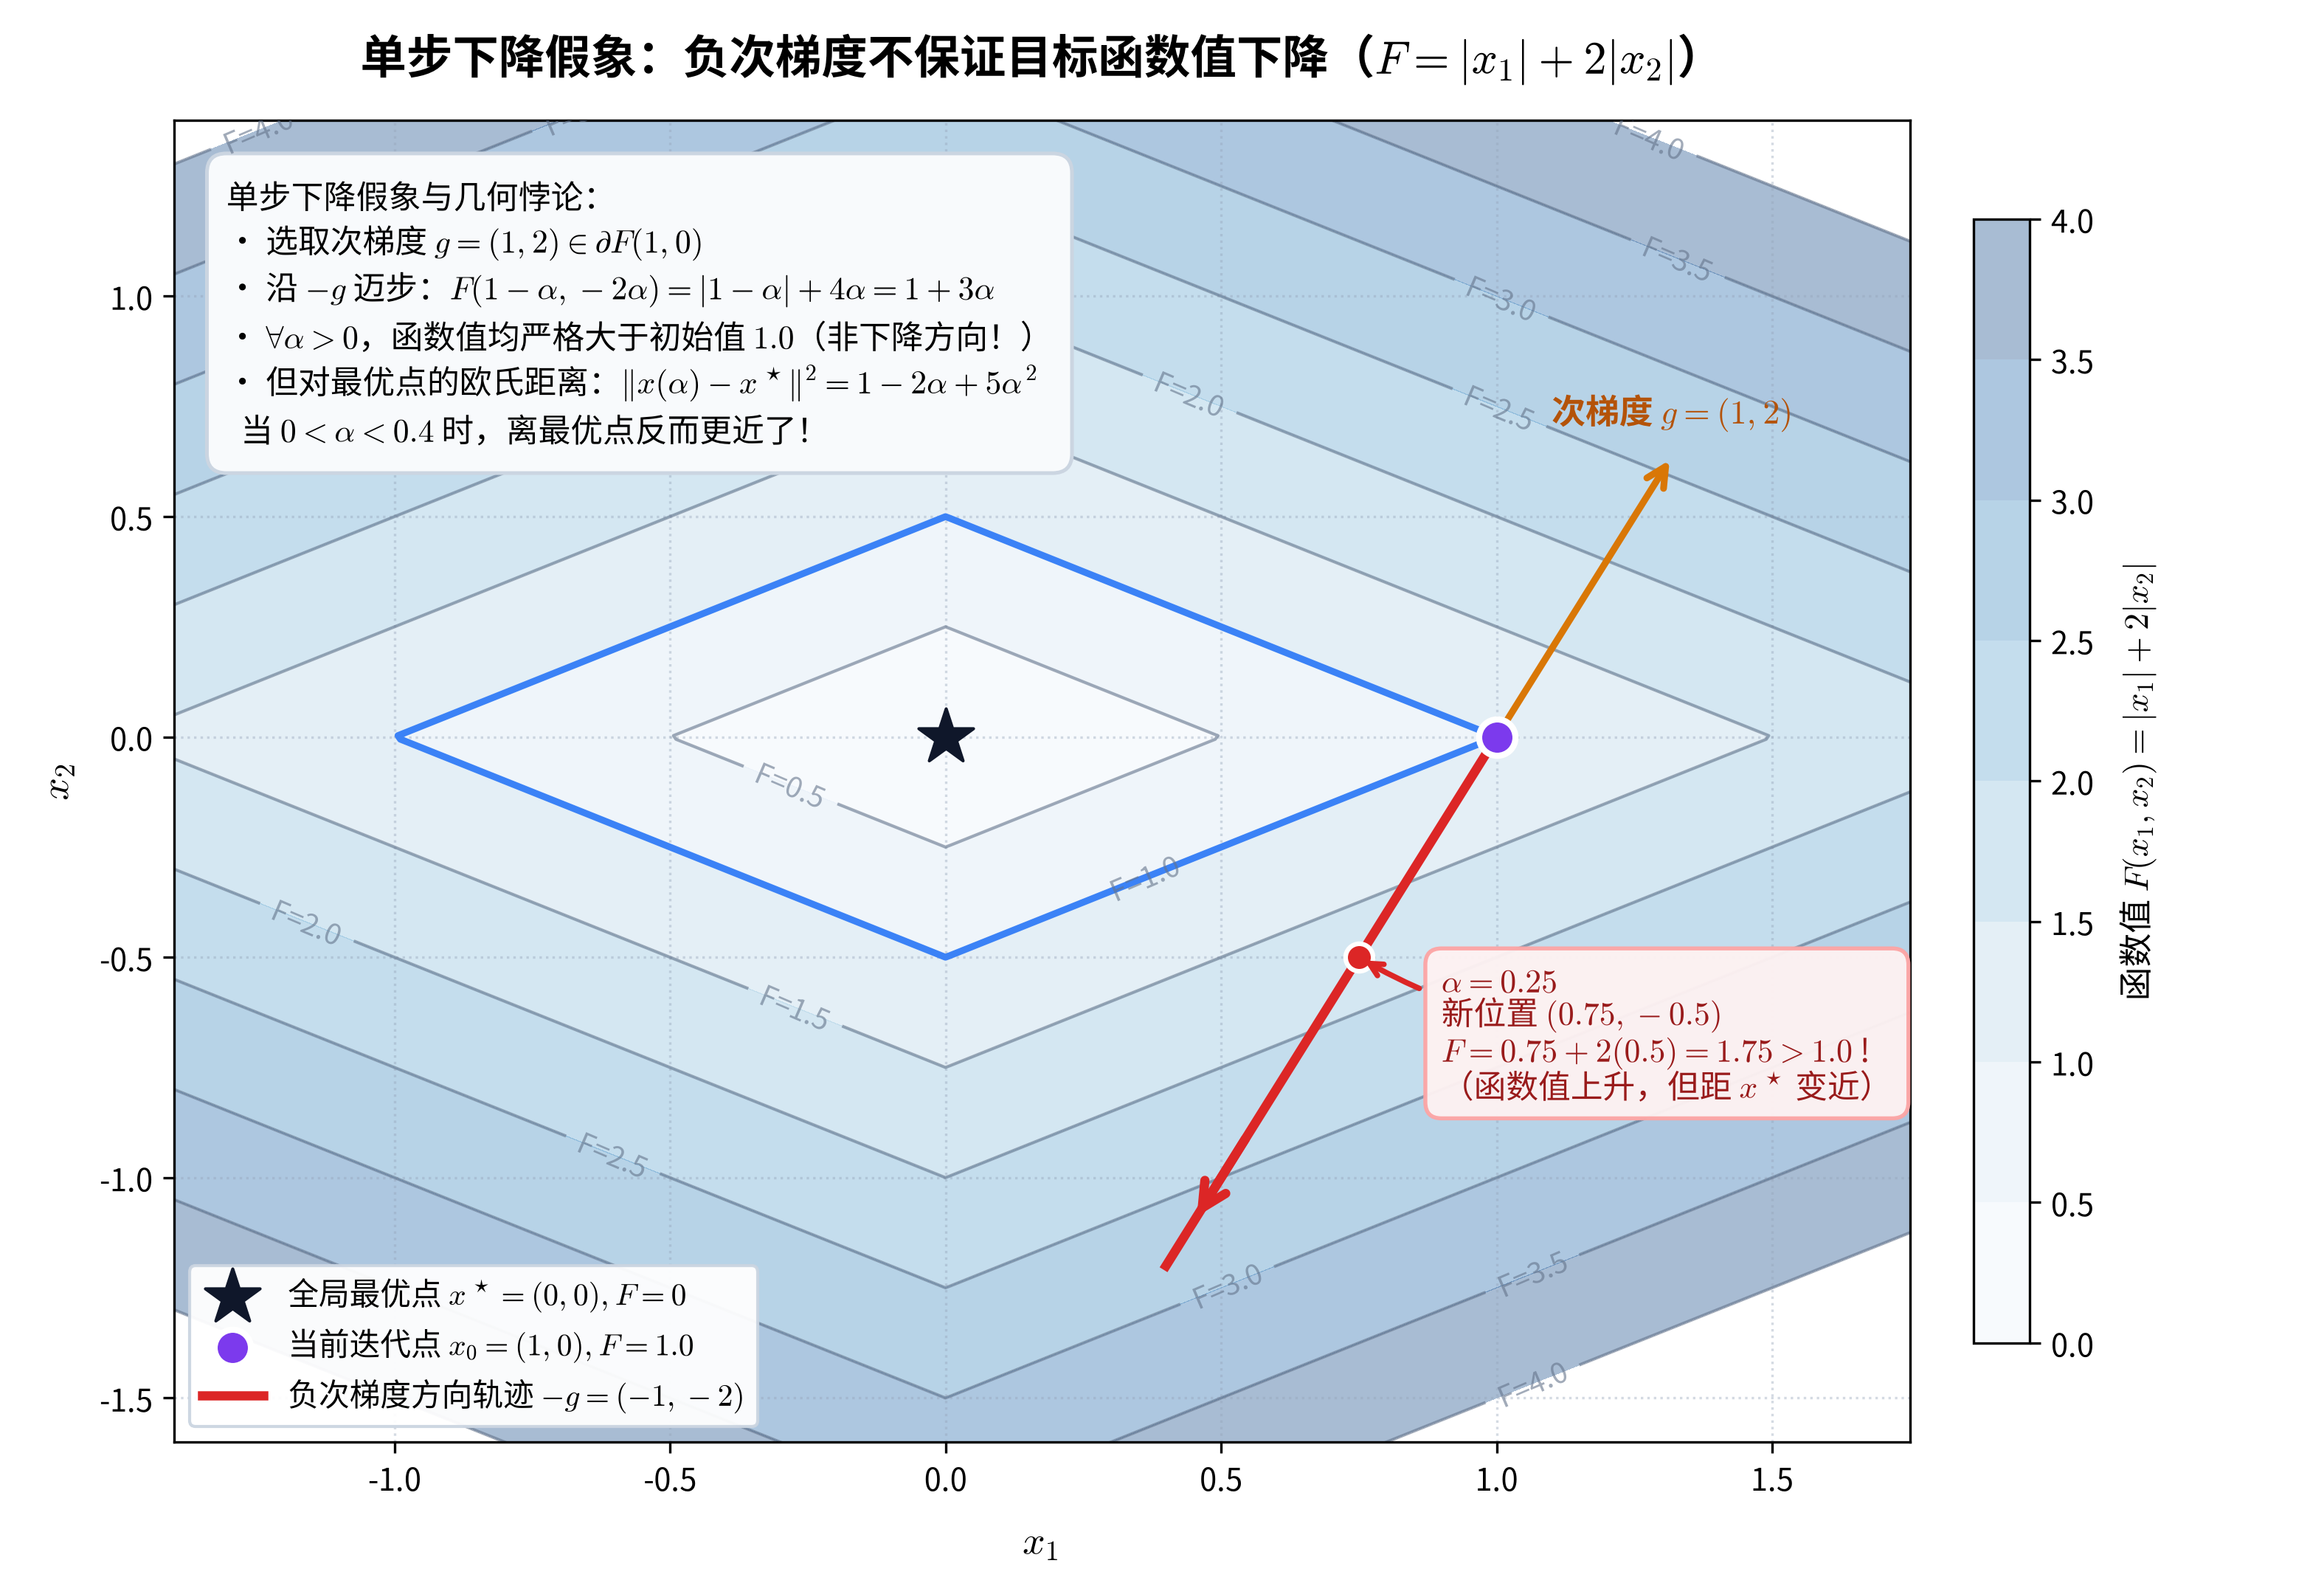
构造反例函数 F(x)=∣x1∣+2∣x2∣F(x)= \vert x_1 \vert + 2 \vert x_2 \vert。让我们取 (1,0)(1, 0) 看一看它的次梯度:

∂F(1,0)={(1,2g2)∣g2∈[−1,1]}\partial F(1, 0) = \left\{ (1, 2 g_2) \mid g_2 \in [-1, 1] \right\}

让我们挑一个合法的次梯度出来:(1,2)(1, 2),那此时的下降方向就是 (−1,−2)(-1, -2)。让我们来看看新位置 (1−α,−2α)(1 - \alpha, -2 \alpha):

F(1−α,−2α)=∣1−α∣+4∣α∣F(1 - \alpha, -2 \alpha) = \vert 1 - \alpha \vert + 4 \vert \alpha \vert

根据绝对值三角不等式,这个式子的最小值仅在 α=0\alpha = 0 处取到。也就是说,对于任何大于 00 的步长,新位置处的函数值都比旧位置处来得大!

单步下降假象:负次梯度不保证目标函数值下降

向负梯度走并不保证单步函数值下降。既然连“单步变好”的信条都崩塌了,次梯度下降法到底凭什么收敛?

累积相消

然而,直觉上我们这样做是能成的。如果把刚才的场景建模成三维空间(x1x_1 对应 XX 轴,x2x_2 对应 YY 轴,F(x)F(x) 对应 ZZ 轴),那就得到了一个四棱锥的侧面,并无限向上延伸。第一步垂直于棱走确实是向上的,可一到了平面上那可就总是下降了。

记 xk+1=xk−αkgkx_{k+1} = x_k - \alpha_k g_k,其中 gk∈∂f(xk)g_k \in \partial f(x_k)。假设初始距离有界 ∥x1−x⋆∥2≤R\Vert x_1 - x^\star \Vert _2 \le R,且满足 L-Lipschitz 连续(可得 ∥gi∥2≤L\Vert g_i \Vert _2 \le L)。

考察到最优点 x⋆x^\star 的欧式距离:

∥xk+1−x⋆∥22=∥xk−αkgk−x⋆∥22=∥xk−x⋆∥22−2αkgk⊤(xk−x⋆)+αk2∥gk∥22\Vert x_{k+1} - x^\star \Vert _2^2 = \Vert x_k - \alpha_k g_k - x^\star \Vert _2^2 = \Vert x_k - x^\star \Vert _2^2 - 2 \alpha_k g_k^\top (x_k - x^\star) + \alpha_k^2 \Vert g_k \Vert _2^2

根据次梯度“托底”的性质,我们有

gk⊤(xk−x⋆)≥f(xk)−f(x⋆)g_k^\top (x_k - x^\star) \ge f(x_k) - f(x^\star)

代入上式,移项整理,得

2αk(f(xk)−f(x⋆))≤∥xk−x⋆∥22−∥xk+1−x⋆∥22+αk2∥gk∥222 \alpha_k (f(x_k) - f(x^\star)) \le \Vert x_k - x^\star \Vert _2^2 - \Vert x_{k+1} - x^\star \Vert _2^2 + \alpha_k^2 \Vert g_k \Vert _2^2

右边是一个明显可以累加相消的形式。让我们累加一下:

∑i=1k2αi(f(xi)−f(x⋆))≤R2+L2∑i=1kαi2\sum_{i=1}^k 2 \alpha_i (f(x_i) - f(x^\star)) \le R^2 + L^2 \sum_{i=1}^k \alpha_i^2

考虑到每次迭代后函数不是单调递减的,所以我们记录到第 kk 个点结束时函数的最小值 fbestk=min⁡1≤i≤kf(xi)f_\text{best}^k = \min_{1 \le i \le k} f(x_i)。显然 fbestk−f(x⋆)≤f(xi)−f(x⋆)f_\text{best}^k - f(x^\star) \le f(x_i) - f(x^\star),所以

2(∑i=1kαi)(fbestk−f(x⋆))≤R2+L2∑i=1kαi22 \left( \sum_{i=1}^k \alpha_i \right) (f_\text{best}^k - f(x^\star)) \le R^2 + L^2 \sum_{i=1}^k \alpha_i^2

即

fbestk−f(x⋆)≤R2+L2∑i=1kαi22∑i=1kαif_\text{best}^k - f(x^\star) \le \frac{R^2 + L^2 \sum_{i=1}^k \alpha_i^2}{2 \sum_{i=1}^k \alpha_i}

步长法则

现在得到的这个公式可以指导我们怎么选步长。

如果我们选取了一个固定步长 αi=α\alpha_i = \alpha,

lim⁡k→∞(fbestk−f(x⋆))≤lim⁡k→∞R2+L2∑i=1kαi22∑i=1kαi=αL22\lim_{k \to \infty} \left(f_\text{best}^k - f(x^\star)\right) \le \lim_{k \to \infty} \frac{R^2 + L^2 \sum_{i=1}^k \alpha_i^2}{2 \sum_{i=1}^k \alpha_i} = \frac{\alpha L^2}{2}

固定步长只能保证最后收敛到最优值的一个固定邻域内。

而假设我们已知要跑 NN 步,希望求一个固定的最优步长,那就对 α\alpha 求极值。可以解得 α⋆=RLN\alpha^\star = \frac{R}{L \sqrt{N}},回代后得到误差上界 RLN\frac{RL}{\sqrt{N }}。

也可以取递减步长 αk=ck\alpha_k = \frac{c}{k} 或 αk=ck\alpha_k = \frac{c}{\sqrt{k}},则有 lim⁡k→∞R2+L2∑i=1kαi22∑i=1kαi=0\lim_{k \to \infty} \frac{R^2 + L^2 \sum_{i=1}^k \alpha_i^2}{2 \sum_{i=1}^k \alpha_i} = 0,此时误差上界收敛至零。

次梯度下降法的最优收敛速率就是 O(1k)O\left(\frac{1}{\sqrt{k}}\right)(或写成 O(1ϵ2)O\left(\frac{1}{\epsilon^2}\right))。它比任何在可微前提下的连续函数优化算法都慢,但也只有它能解决非光滑的问题。

LASSO 回归

让我们实操一下,看看 LASSO 回归是怎么下降的。

min⁡xf(x)=1n∥Ax−b∥22+μ∥x∥1\min_x f(x) = \frac{1}{n}\Vert Ax - b \Vert _2^2 + \mu \Vert x \Vert _1

对于前半截的光滑部分,∇(1n∥Ax−b∥22)=2nA⊤(Ax−b)\nabla \left(\frac{1}{n}\Vert Ax - b \Vert _2^2\right) = \frac{2}{n} A^\top(Ax - b)。

对于后半截的非光滑部分,∂(μ∥x∥1)=μ∂∥x∥1\partial (\mu \Vert x \Vert _1) = \mu \partial \Vert x \Vert _1。∥x∥1=(1⋮1)⊤(∣x1∣⋮∣xn∣)\Vert x \Vert _1 = \begin{pmatrix} 1 \\ \vdots \\ 1 \end{pmatrix}^\top \begin{pmatrix} \vert x_1 \vert \\ \vdots \\ \vert x_n \vert \end{pmatrix},∂∣xi∣={{−1},xi<0{1},xi>0[−1,1],xi=0\partial \vert x_i \vert = \begin{cases}\{-1\},&x_i<0 \\ \{1\},&x_i>0 \\ [-1, 1],&x_i=0 \end{cases}。不难得到

∂∥x∥1={(s1⋮sn)∣si∈∂∣xi∣={{−1},xi<0{1},xi>0[−1,1],xi=0}\partial \Vert x \Vert _1 = \left\{ \left. \begin{pmatrix} s_1 \\ \vdots \\ s_n \end{pmatrix} \right| s_i \in \partial \vert x_i \vert = \begin{cases} \{-1\},& x_i<0 \\ \{1\},& x_i>0 \\ [-1, 1],& x_i=0 \end{cases} \right\}

在实际计算中,若遇到等于 00 的分量,只需在区间 [−1,1][-1, 1] 中任挑一个值(通常直接选 00),得到次梯度:gk=2nA⊤(Axk−b)+μsign⁡(xk)g_k = \frac{2}{n} A^\top (Ax_k - b) + \mu \operatorname{sign}(x_k)。然后执行更新 xk+1=xk−αkgkx_{k+1} = x_k - \alpha_k g_k。

这里也能导出 LASSO 回归的有趣特性:f(x)f(x) 的最小值处 0∈∂f(x⋆)0 \in \partial f(x^\star)。代入展开即得到

0∈2nA⊤(Ax⋆−b)+μ∂∥x⋆∥10 \in \frac{2}{n} A^\top(A x^\star - b) + \mu \partial \Vert x^\star \Vert _1

移项,有

2nA⊤(b−Ax⋆)∈μ∂∥x⋆∥1\frac{2}{n} A^\top (b - Ax^\star) \in \mu \partial \Vert x^\star \Vert _1

令残差向量 r⋆=b−Ax⋆r^\star = b - A x^\star,矩阵的第 ii 列特征为 AiA_i,对每行单独展开,有

2nAi⊤r⋆∈μ∂∣xi⋆∣\frac{2}{n} A_i^\top r^\star \in \mu \partial \vert x_i^\star \vert

那么,当 xi⋆>0x_i^\star > 0 时,2nAi⊤r⋆=μ\frac{2}{n} A_i^\top r^\star = \mu;当 xi⋆<0x_i^\star < 0 时,2nAi⊤r⋆=−μ\frac{2}{n} A_i^\top r^\star = -\mu;而当 xi⋆=0x_i^\star = 0 时,∣2nAi⊤r⋆∣≤μ\left\vert \frac{2}{n} A_i^\top r^\star \right\vert \le \mu。

这意味着,只要某个特征与当前残差的相关性没有突破惩罚阈值(即处于 [−μ,μ][-\mu, \mu] 区间内),该特征的系数就会被压缩为 00。这也就是 LASSO 回归稀疏性的数学原理。