在之前的梯度下降法中,我们提到,即使在精确线搜索下,梯度下降法也大概率走出一条全是直角拐弯的优化路径。牛顿法虽然解决了这个问题,然而它的存储开销和计算开销实在太大了。我们最希望的当然是既只用一阶梯度,又能快速下降。
在通常的函数中这可能比较难以做到,那让我们退而求其次,来考察一下严格正定的二次型函数:
f(x)=21x⊤Ax−b⊤x,A∈Rn×n,A≻0,A⊤=A
求这个函数的最小值当然就是求 ∇f(x)=Ax−b=0。
其实,共轭梯度法最初在 1952 年就是为了求出 Ax=b 而设计的。不过这里我们为了逻辑上的通畅,选择先有函数再算梯度的逻辑。
直观感受
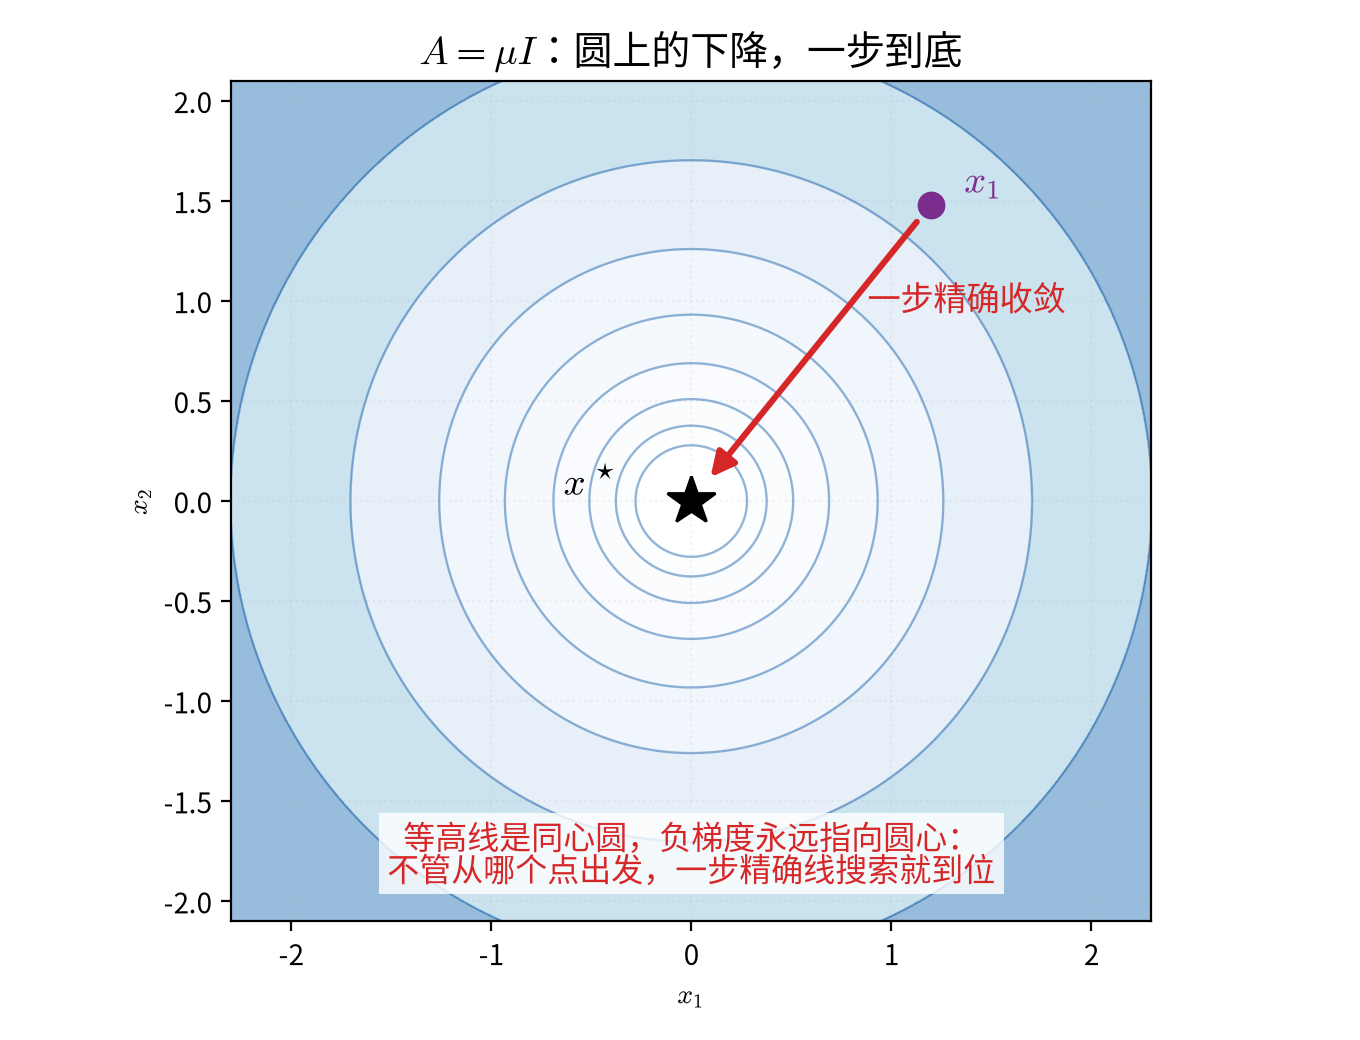
在一个圆上进行下降,不管从什么地方出发都是一步的事。此时,A=μI,x⋆=μ1b。
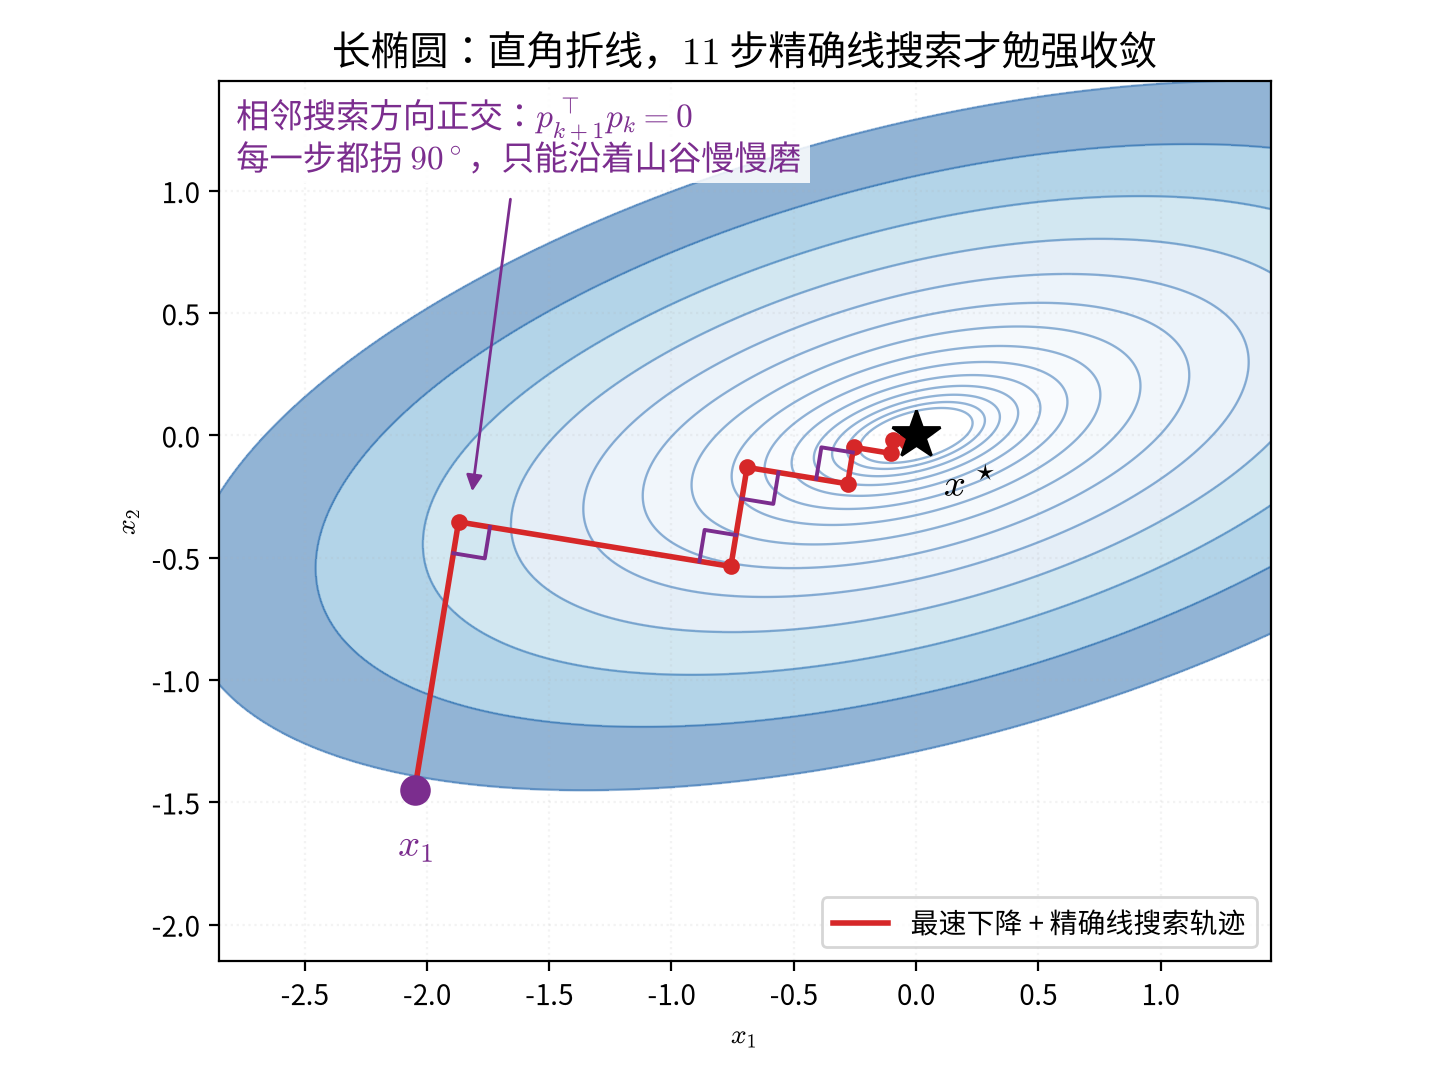
在一个椭圆上就不然。椭圆上的下降曲线要不断拐弯,逼近得很慢。而且即使每步都用精确线搜索优化到了最佳,下一步又会破坏已知的最优。
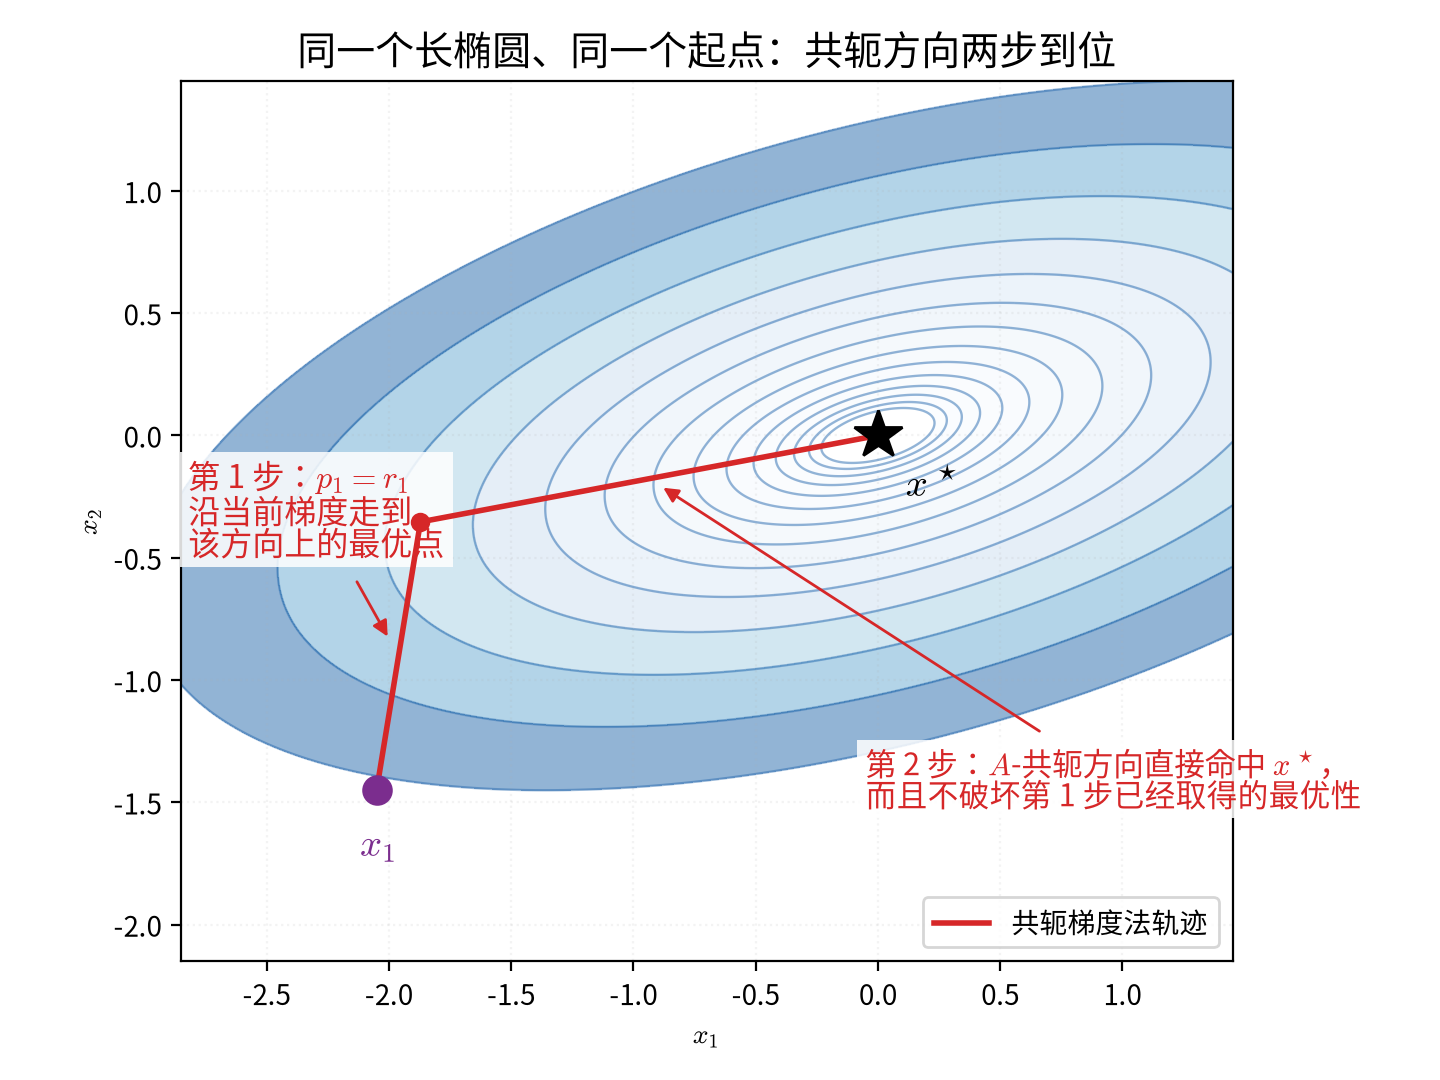
那我们的想法当然是,能不能第一步最优,第二步在把不破坏第一步最优的基础上也最优,第三步在不破坏前两步最优的基础上也最优……
如何下降
那么,应该怎么走呢?
比较直观的想法是,矩阵是一个 n×n 的东西,而梯度是一个 n×1 的东西,所以大概 n 次就能从任意点收敛到最优值。而且,因为要走 n 步,每步都走“尽” Rn 的一个维度,所以每走一步都要走到当前步最优的位置,而且肯定不能损害前一步的最优性。
我们经常算便宜的梯度 ∇f(xk)=Axk−b。另外,我们还知道 ∇f(x⋆)=Ax⋆−b=0。我们希望最终 xk=x⋆,即误差 ek=xk−x⋆=0,所以会想把上面这两个式子做个差 ∇f(xk)−∇f(x⋆)=∇f(xk)=A(xk−x⋆)=Aek,得到 ∇f(xk)=Aek。这个式子看上去很有意思,我们先记下来。
把我们沿着走的方向记为 p1,p2,…,pn。我们希望最后满足 −e1=∑i=1nαipi。
那么当走了 k 步时,我们应该怎么知道第 k+1 步往哪儿走,走多远呢?
走多远
假设上帝已经给了我们一组能够铺满全空间的搜索方向 p1,p2,…,pn。
在走完前 k−1 步后,当前的累积位置是 xk=x1+∑i=1k−1αipi,当前的剩余误差是 ek=xk−x⋆。从全局来看,我们还剩下的总差距是:
−ek=x⋆−xk=i=k∑nαipi
我们希望在第 k 步就把这个式子中的 αk 解出来,并且不用知道未来还要走多远,怎么走。总的来说,我们希望 pi 和 pj 之间满足某种联系,使得它们能进行顺滑的消消乐。
最常规的联系就是两两垂直,即 pi⊤pj=0(i=j)。然而,即使满足这个条件,把上式两边都左乘一个 pk,我们也只能得到
−pk⊤ek=αk∥pk∥2+i=k+1∑nαi(pk⊤pi)=αk∥pk∥2
问题是很明显的:我们不知道终末状态,所以 ek 也无从得知。
然后你突然想起来上面那个神秘的式子:∇f(xk)=Aek。如果我们左乘一个 pk⊤A,又会得到什么呢?
−pk⊤Aek=αk(pk⊤Apk)+i=k+1∑nαi(pk⊤Api)
化简,
−pk⊤∇f(xk)=αk(pk⊤Apk)+i=k+1∑nαi(pk⊤Api)
刚刚上帝给了你 p1 到 pn,所以 pk 是已知的。A 和 ∇f(xk) 当然也是已知的。这么看来,你要求 αk,最方便的办法当然就是让后面那一大串求和等于零,也就是
pi⊤Apj=0,i=j
这就是大名鼎鼎的共轭条件。而在这个条件下,每步的步长就是
αk=pk⊤Apk−pk⊤∇f(xk)
往哪儿走
现在我们知道走多远了,那么问题就转化为往哪儿走。很遗憾,现实生活中可没有上帝,我们还是得解决已知 p1,…,pk−1,如何求 pk 的问题。
幸好,在上面的推理中,我们还顺便得到了 pi⊤Apj=0,i=j 的共轭关系。
最简单的想法当然是用施密特正交化。
我们拿手头上现成的向量 ∇f(xk) 来做每步的施密特正交化。定义残差 rk=Ax⋆−Axk=b−Axk=−∇f(xk)。那么理论上,下一个方向就是
pk=rk−i=1∑k−1pi⊤Apipi⊤Arkpi
不过,施密特正交化是 O(n3) 的算法,和矩阵求逆一样麻烦。我们看看能不能找到一点好的性质避免这么高的时间复杂度。
我们在第 k 步所处的位置 xk,实际上是在前 k−1 个共轭方向张成的子空间内达到了全局最优。这意味着当前的梯度与已有的所有搜索方向都正交,也就是说:
rk⊤pi=0,∀i<k
第一个搜索方向没有前面的信息,我们干脆定义 p1=r1,而每次 pk 都是用之前的 p1,…,pk−1 和 rk 来更新的。所以我们显然有 span{p1,…,pk}=span{r1,…,rk}。
在第 k 个点处,我们有 rk⊤pi=0,∀i<k 和 span{p1,…,pk−1}=span{r1,…,rk−1}。所以,我们得到:
rk⊤ri=0,∀i<k
回顾残差的更新方式:
ri+1=b−Axi+1=b−A(xi+αipi)=ri−αiApi
Api=αi1(ri−ri+1)
代入到施密特正交化的分子上:
pi⊤Ark=rk⊤Api=αi1rk⊤(ri−ri+1)
又根据前面得到的 rk⊤ri=0,∀i<k,我们知道
pi⊤Ark=αi1rk⊤(ri−ri+1)={0−αk−11∥rk∥2i<k−1i=k−1
因此,
pk=rk−pk−1⊤Apk−1−αk−11∥rk∥2pk−1
其实这个式子的分母还可以用 Apk−1=αk−11(rk−1−rk)、pk−1⊤rk−1=rk−1⊤rk−1 和 pk−1⊤rk=0 继续化简,得到
pk=rk+∥rk−1∥2∥rk∥2pk−1
这样一来,站在当前点的下降方向只需要用当前点的梯度、上一个点的梯度和上一个点的下降方向就可以得出。这大大节省了存储空间。
总览
初步的共轭梯度法先设定 r1=b−Ax1,p1=r1,接下来进行迭代:
αkxk+1rk+1βk+1pk+1=pk⊤Apkpk⊤rk=xk+αkpk=b−Axk+1=−pk⊤Apkpk⊤Ark+1=rk+1+βk+1pk
而更进一步化简后的共轭梯度法同样先设定 r1=b−Ax1,p1=r1,不过接下来则是:
αkxk+1rk+1βk+1pk+1=pk⊤Apk∥rk∥2=xk+αkpk=rk−αkApk=∥rk∥2∥rk+1∥2=rk+1+βk+1pk
化简后,矩阵-向量乘法的次数从每轮 2-3 次减少为严格 1 次,向量点积每轮迭代仅计算两次,且保证了 O(n) 的时间复杂度,是实际场景下的高效实现。